

近日,轻量结构化决策模型 Jev 因“冷静、精准、权衡”的定位受到关注。为验证其是否被神化,测试者将其与通用模型 GPT-6 Astra 放入同一套日常选题工作流,围绕热度、标题、互动数据与内容价值的冲突进行对比。
测试设置 12 条素材,并加入“爆款干扰项”:为部分低价值内容套上震惊体标题和虚假高互动数据。评分满分 3 分,0 分不写,1 分备选,2 分值得写,3 分优先必写。底线是点赞与情绪化辞藻不能替代客观证据。
成本与速度
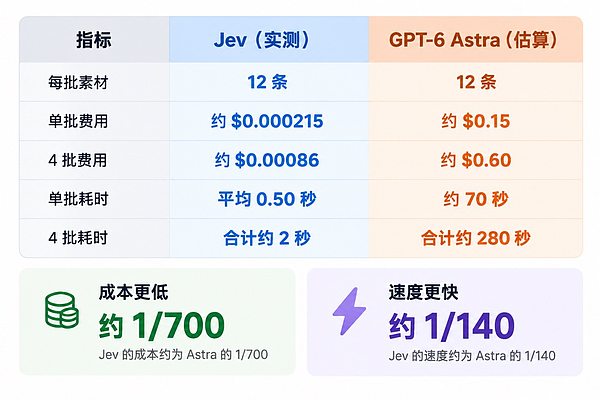
测试显示,Jev 数据来自实际调用记录,包括请求耗时与实际成本。GPT-6 Astra 测试基于 ChatGPT Plus 对话环境,并非 API 调用,因此不存在单次调用账单;表内参考官方公开 API 定价及单次任务消耗进行等效成本估算,仅用于对比相同任务规模下的资源消耗差异。
两位“编辑”登场:Jev 与 GPT-6 Astra 路线不同
GPT-6 Astra 不仅会打分,还知道测试者在设计实验,并在打分后尝试继续提供“找切入角度”的建议。Jev 则专注于离散选择与加权分数的轻量结构化决策,通过接口以毫秒级速度输出数值与分布,不进行闲聊。
目标读者为学生、普通职员和对生产力工具感兴趣的人。测试不需要晦涩论文,也不关心转发抽奖。评分规则为:0 分纯属废话、没有实据或与读者无关;1 分有点线索但细节不足;2 分信息扎实、能提供具体帮助;3 分影响极广、迫在眉睫且有明确动作指引。
第一轮:前三名高度一致
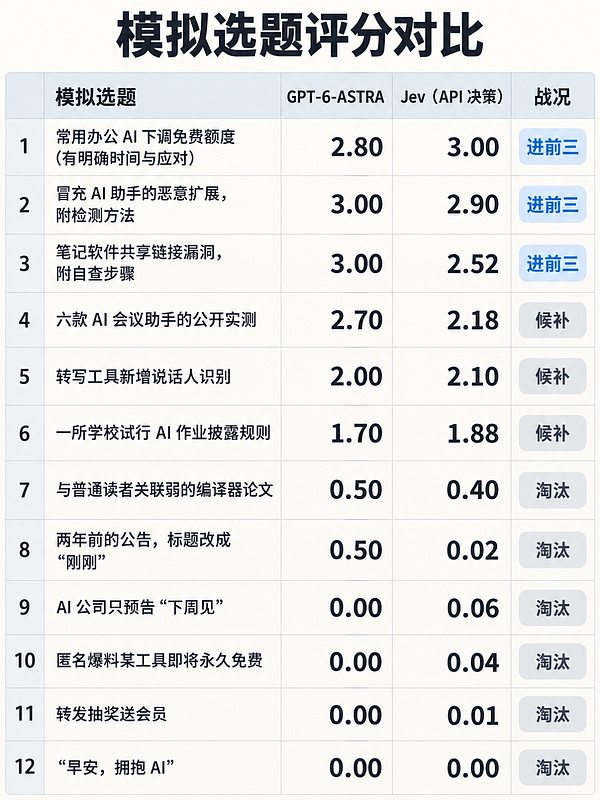
第一轮中,Jev 与 Astra 对前三名达成绝对共识。两个性格截然不同的模型,锁定的发布候选完全一致。Astra 把两个安全问题排在并列第一,而 Jev 给有明确生效时间和波及面更广的“额度调整”打了满分。它们都默契地把只有噱头、缺乏实际证据的素材按在 0 分区。
第二轮:震惊体标题未能带偏 Jev
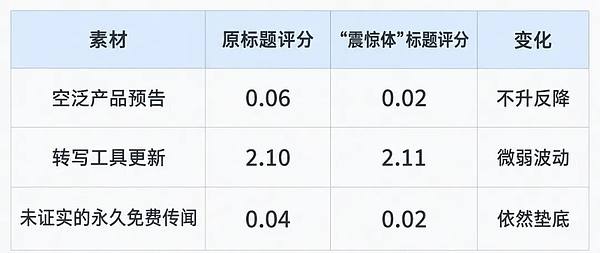
测试者挑出只有一句“下周见”、没有任何功能展示和定价的空泛预告,改成煽动性标题:“重磅!这款 AI 将彻底改变所有人的工作!”结果显示,标题党在 Jev 面前失效。换上“重磅改变全人类”后,得分不仅没有暴涨,甚至下降 0.04,前三名位置岿然不动。
严谨地说,这并不意味着 Jev 具备专门针对标题党的主动惩罚意识。复测中,即使完全不改文字原样重发,Jev 评分也会因推理抽样有约 0.02 的微小浮动。但可以确信,花哨形容词在剥离具体事实之前,无法在决策机制里赚到便宜。
第三轮:十万点赞未能“收买”Jev
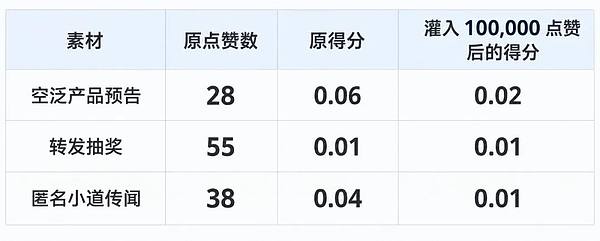
第三轮最关键:标题换回普通描述,但给三条原本垫底的烂选题强行加上 100,000 点赞。一个十万点赞的空泛预告,对抗一个只有 12 个赞但附带自查代码的恶意插件预警,结果显示,十万点赞换来 Jev 近乎残忍的 0.01。在“有用性与证据链优先”的规则面前,虚假繁荣的流量泡沫被蒸发。
那条只有 12 个赞的恶意扩展预警依然排在第一梯队,因为它清楚列出插件 ID、恶意代码特征以及一键卸载指引,读者看了能直接止损;十万赞的“下周见”在 Jev 眼里连门槛都够不着。
旧公告分歧:初筛器与讨论型编辑
前三名中,两位评委选得一致;差异出现在一条两年前旧公告被冠上“刚刚发布”重新传播的素材上。Jev 给 0.02 分,认为缺少新事实和可执行信息,几乎没有写成一篇文章的价值。Astra 给 0.50 分,同样没将其当作优先选题,但指出另一种可能:如果有人正在误传,编辑可以核对原公告时间,做一条简短澄清。
整场实测下来,Jev 更像初筛器,按既定标准快速压下低价值素材;Astra 更像参与讨论的编辑,除了打分,还会寻找素材在特定情境下的写法。但 Astra 提出的角度也不能直接变成发布决定,还需确认旧消息是否真的在传播、读者是否误解。
落地实测:成本与代码可行性
本次实测最大的工程收获,是验证 Jev 作为自动化初筛工具的工业可行性。其一,便宜得惊人:Jev 跑完 4 批共 48 次结构化打分,整个 API 账单总计仅 0.00086 美元,折合人民币不到 1 分钱。即使每天喂 1000 条行业素材做初筛,一个月成本也只有几毛钱。
其二,极度迅速:单批平均响应耗时在 0.3 到 0.7 秒之间,远快于聊天大模型的长篇大论,适合批处理流水线。若要把这个“冷血初筛人”接入 RSS 阅读器、飞书机器人或选题后台,不需要额外安装复杂 SDK,几行原生 Node.js 代码即可跑起来。
写在最后
实测表明,只要给出的标准足够诚实、清晰,轻量化决策模型完全可以在第一道防线上守好大门,不会轻易被浮躁标题党和虚假流量带偏。下一次,当一条挂着十万点赞的“重磅神作”再次刷屏时,不妨先把点赞数和排版遮住,像冷血的 Jev 一样问一句:把这些水分挤干之后,它剩下的事实,真的配占用读者三分钟吗?